ਨਕਲੀ ਬੁੱਧੀ ਦੀ ਵਰਤੋਂ ਸਿਹਤ ਸੰਭਾਲ ਵਿੱਚ ਵਧੇਰੇ ਵਿਆਪਕ ਤੌਰ ‘ਤੇ ਕੀਤੀ ਜਾ ਰਹੀ ਹੈ, ਪਰ ਇੱਕ ਨਵਾਂ ਅਧਿਐਨ ਸੁਝਾਅ ਦਿੰਦਾ ਹੈ ਕਿ ਇਹ ਓਨਾ ਭਰੋਸੇਮੰਦ ਨਹੀਂ ਹੋ ਸਕਦਾ ਜਿੰਨਾ ਇਹ ਦਿਖਾਈ ਦਿੰਦਾ ਹੈ, ਖਾਸ ਕਰਕੇ ਇਸ ਵਿੱਚ ਕਿ ਇਹ ਇੱਕ ਕੇਸ ਦੁਆਰਾ “ਸੋਚਦਾ ਹੈ”।
ਮਾਸ ਜਨਰਲ ਬ੍ਰਿਘਮ ਦੇ ਖੋਜਕਰਤਾਵਾਂ ਨੇ 21 ਵੱਡੇ ਏਆਈ ਮਾਡਲਾਂ ਦੀ ਜਾਂਚ ਕੀਤੀ, ਜਿਸ ਵਿੱਚ ਚੈਟਜੀਪੀਟੀ, ਜੇਮਿਨੀ, ਕਲਾਉਡ, ਗ੍ਰੋਕ ਅਤੇ ਡੀਪਸੀਕ ਸ਼ਾਮਲ ਹਨ, ਨੂੰ 29 ਕਲੀਨਿਕਲ ਮਾਮਲਿਆਂ ਵਿੱਚ ਡਾਕਟਰਾਂ ਵਾਂਗ ਕੰਮ ਕਰਨ ਲਈ ਕਹਿ ਕੇ।
ਜਾਮਾ ਨੈੱਟਵਰਕ ਓਪਨ ਵਿੱਚ ਪ੍ਰਕਾਸ਼ਿਤ ਖੋਜਾਂ, ਇੱਕ ਸਪਸ਼ਟ ਪਾੜਾ ਦਰਸਾਉਂਦੀਆਂ ਹਨ। ਜਦੋਂ ਮਰੀਜ਼ ਦੀ ਪੂਰੀ ਜਾਣਕਾਰੀ ਦਿੱਤੀ ਜਾਂਦੀ ਹੈ, ਤਾਂ ਮਾਡਲ 90% ਤੋਂ ਵੱਧ ਸਮੇਂ ਦੇ ਸਹੀ ਅੰਤਮ ਨਿਦਾਨ ‘ਤੇ ਪਹੁੰਚੇ।
ਪਰ ਜਦੋਂ ਖੋਜਕਰਤਾਵਾਂ ਨੇ ਕਦਮ-ਦਰ-ਕਦਮ ਤਰਕ ਨੂੰ ਦੇਖਿਆ, ਜਿਵੇਂ ਕਿ ਸੰਭਾਵਿਤ ਕਾਰਨਾਂ ਨੂੰ ਸੂਚੀਬੱਧ ਕਰਨਾ ਅਤੇ ਇਹ ਫੈਸਲਾ ਕਰਨਾ ਕਿ ਕਿਹੜੇ ਟੈਸਟ ਚਲਾਉਣੇ ਹਨ, ਤਾਂ ਮਾਡਲਾਂ ਨੇ ਮਾੜਾ ਪ੍ਰਦਰਸ਼ਨ ਕੀਤਾ। ਵਾਸਤਵ ਵਿੱਚ, ਉਹ 80% ਤੋਂ ਵੱਧ ਸਮੇਂ ਦੇ ਸੰਭਾਵੀ ਨਿਦਾਨਾਂ ਦੀ ਇੱਕ ਢੁਕਵੀਂ ਸੂਚੀ ਤਿਆਰ ਕਰਨ ਵਿੱਚ ਅਸਫਲ ਰਹੇ।
ਪਾੜਾ ਮੌਜੂਦ ਹੈ ਅਤੇ ਨਿਦਾਨ ਵਿੱਚ ਮਾਇਨੇ ਰੱਖਦਾ ਹੈ
ਇਸਦਾ ਮਤਲਬ ਇਹ ਹੈ ਕਿ ਜਦੋਂ ਕਿ AI ਸਹੀ ਉੱਤਰ ‘ਤੇ ਉਤਰ ਸਕਦਾ ਹੈ, ਇਹ ਅਕਸਰ ਡਾਕਟਰਾਂ ਦੁਆਰਾ ਭਰੋਸੇਮੰਦ ਪ੍ਰਕਿਰਿਆ ਨਾਲ ਸੰਘਰਸ਼ ਕਰਦਾ ਹੈ, ਸੁਰੱਖਿਅਤ ਡਾਕਟਰੀ ਦੇਖਭਾਲ ਦਾ ਇੱਕ ਮੁੱਖ ਹਿੱਸਾ।
ਮੁੱਖ ਲੇਖਕ ਅਤੇ ਖੋਜਕਰਤਾ ਆਰੀਆ ਰਾਓ ਨੇ ਕਿਹਾ, “ਇਹ ਮਾਡਲ ਇੱਕ ਵਾਰ ਡਾਟਾ ਪੂਰਾ ਹੋਣ ਤੋਂ ਬਾਅਦ ਇੱਕ ਅੰਤਮ ਤਸ਼ਖ਼ੀਸ ਦਾ ਨਾਮ ਦੇਣ ਵਿੱਚ ਬਹੁਤ ਵਧੀਆ ਹਨ, ਪਰ ਇਹ ਇੱਕ ਕੇਸ ਦੀ ਸ਼ੁਰੂਆਤੀ ਸ਼ੁਰੂਆਤ ਵਿੱਚ ਸੰਘਰਸ਼ ਕਰਦੇ ਹਨ, ਜਦੋਂ ਬਹੁਤ ਜ਼ਿਆਦਾ ਜਾਣਕਾਰੀ ਨਹੀਂ ਹੁੰਦੀ ਹੈ,” ਆਰੀਆ ਰਾਓ, ਮੁੱਖ ਲੇਖਕ ਅਤੇ ਖੋਜਕਰਤਾ ਨੇ ਕਿਹਾ।
ਇਸ ਨੂੰ ਬਿਹਤਰ ਢੰਗ ਨਾਲ ਸਮਝਣ ਲਈ, ਖੋਜਕਰਤਾਵਾਂ ਨੇ ਇੱਕ ਨਵੀਂ ਸਕੋਰਿੰਗ ਪ੍ਰਣਾਲੀ ਦੀ ਵਰਤੋਂ ਕੀਤੀ ਜਿਸ ਨੇ ਨਿਦਾਨ ਦੇ ਵੱਖ-ਵੱਖ ਪੜਾਵਾਂ ਦਾ ਮੁਲਾਂਕਣ ਕੀਤਾ, ਸ਼ੁਰੂਆਤੀ ਸੋਚ ਤੋਂ ਇਲਾਜ ਦੇ ਫੈਸਲਿਆਂ ਤੱਕ।
Gemini 1.5 Flash ਲਈ 64% ਤੋਂ ਲੈ ਕੇ Grok 4 ਅਤੇ GPT-5 ਵਰਗੇ ਨਵੇਂ ਮਾਡਲਾਂ ਲਈ 78% ਤੱਕ ਸਕੋਰ ਹਨ, ਜੋ ਅਸਮਾਨ ਪ੍ਰਦਰਸ਼ਨ ਦਿਖਾਉਂਦੇ ਹਨ।
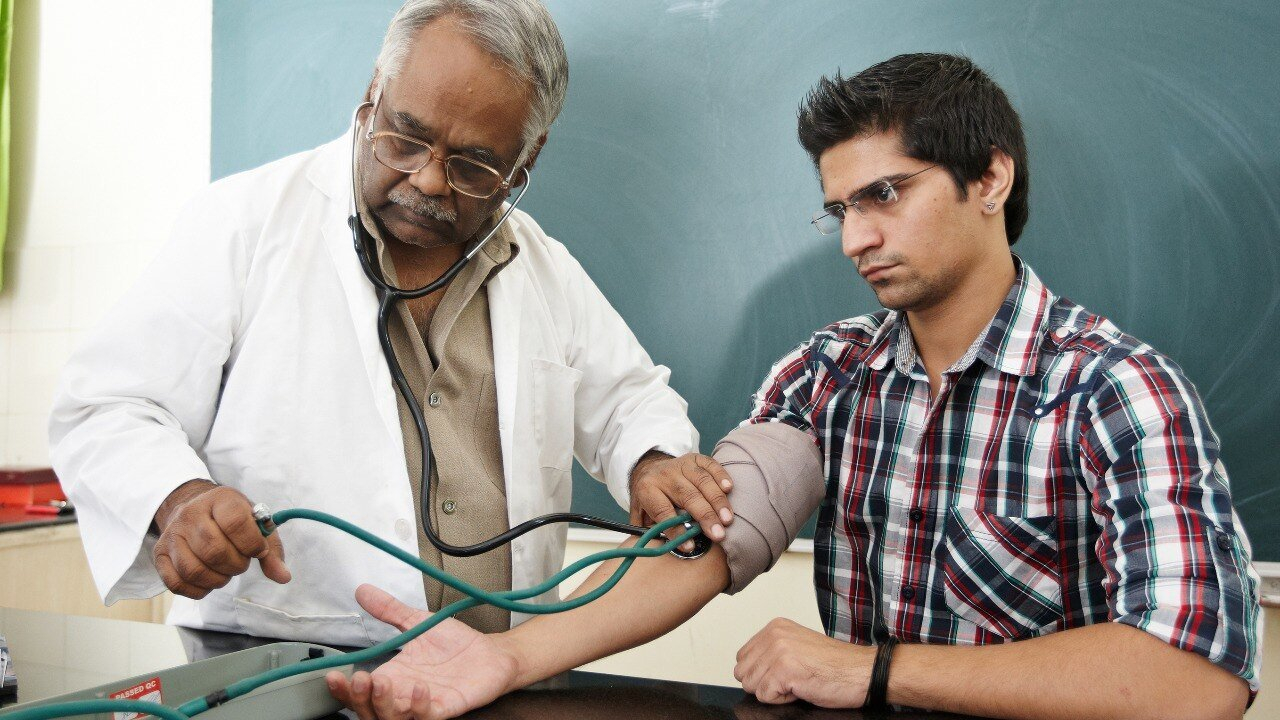
ਹਾਲਾਂਕਿ AI ਸਹੀ ਜਵਾਬ ‘ਤੇ ਉਤਰ ਸਕਦਾ ਹੈ, ਇਹ ਅਕਸਰ ਡਾਕਟਰਾਂ ਦੁਆਰਾ ਭਰੋਸੇ ਦੀ ਪ੍ਰਕਿਰਿਆ ਨਾਲ ਸੰਘਰਸ਼ ਕਰਦਾ ਹੈ, ਸੁਰੱਖਿਅਤ ਡਾਕਟਰੀ ਦੇਖਭਾਲ ਦਾ ਇੱਕ ਮੁੱਖ ਹਿੱਸਾ। (ਫੋਟੋ: Getty Images)
ਸਰਲ ਸ਼ਬਦਾਂ ਵਿੱਚ, ਖੋਜਕਰਤਾਵਾਂ ਨੇ ਪਾਇਆ ਕਿ ਜਦੋਂ ਕਿ ਨਵੀਨਤਮ ਟੂਲ ਸਹੀ ਅੰਤਮ ਨਿਦਾਨ ਦੇ ਸਕਦੇ ਹਨ, ਉਹ ਇੱਕ ਕੇਸ ਦੁਆਰਾ ਸੋਚਣ ਦੇ ਪਹਿਲੇ ਕਦਮਾਂ ਨਾਲ ਸੰਘਰਸ਼ ਕਰਦੇ ਹਨ।
ਉਹਨਾਂ ਨੂੰ ਸੰਭਾਵਿਤ ਕਾਰਨਾਂ ਦੀ ਸੂਚੀ ਬਣਾਉਣ ਅਤੇ ਅਨਿਸ਼ਚਿਤਤਾ ਨਾਲ ਨਜਿੱਠਣ ਵਿੱਚ ਮੁਸ਼ਕਲ ਸੀ।
AI ਵਧੇਰੇ ਡੇਟਾ ਦੇ ਨਾਲ ਬਿਹਤਰ ਹੈ ਪਰ ਅਜੇ ਵੀ ਸੀਮਿਤ ਹੈ
ਅਧਿਐਨ ਵਿੱਚ ਇਹ ਵੀ ਪਾਇਆ ਗਿਆ ਕਿ ਜਦੋਂ ਵਧੇਰੇ ਡੇਟਾ, ਜਿਵੇਂ ਕਿ ਲੈਬ ਨਤੀਜੇ ਅਤੇ ਸਕੈਨ ਦਿੱਤੇ ਜਾਂਦੇ ਹਨ ਤਾਂ AI ਵਿੱਚ ਸੁਧਾਰ ਹੁੰਦਾ ਹੈ। ਪਰ ਅਸਲ ਜ਼ਿੰਦਗੀ ਵਿੱਚ, ਡਾਕਟਰਾਂ ਕੋਲ ਸ਼ਾਇਦ ਹੀ ਸਾਰੀ ਜਾਣਕਾਰੀ ਸਾਹਮਣੇ ਹੋਵੇ।
ਖੋਜਕਰਤਾਵਾਂ ਨੇ ਚੇਤਾਵਨੀ ਦਿੱਤੀ ਹੈ ਕਿ ਇਹ ਅੰਤਰ ਬਹੁਤ ਸਾਰੀਆਂ ਅਸਲ-ਸੰਸਾਰ ਸਥਿਤੀਆਂ ਵਿੱਚ AI ਨੂੰ ਗੁੰਮਰਾਹ ਕਰ ਸਕਦਾ ਹੈ, ਖਾਸ ਤੌਰ ‘ਤੇ ਸ਼ੁਰੂਆਤੀ ਨਿਦਾਨ ਵਿੱਚ ਜਦੋਂ ਅਨਿਸ਼ਚਿਤਤਾ ਸਭ ਤੋਂ ਵੱਧ ਹੁੰਦੀ ਹੈ।
ਉਦਾਹਰਨ ਲਈ, GPT-4o, Claude, ਅਤੇ DeepSeek ਵਰਗੇ ਮਾਡਲ ਸਪਸ਼ਟ ਤੌਰ ‘ਤੇ ਵਧੇਰੇ ਸਟੀਕ ਸਨ ਜਦੋਂ ਅੰਤਿਮ ਤਸ਼ਖ਼ੀਸ ਲਈ ਪੁੱਛਿਆ ਗਿਆ ਸੀ ਜਦੋਂ ਇਹ ਪੁੱਛਿਆ ਗਿਆ ਸੀ ਕਿ ਕਿਹੜੇ ਟੈਸਟ ਚਲਾਉਣੇ ਹਨ ਜਾਂ ਪਹਿਲਾਂ ਕਿਹੜੀਆਂ ਸਥਿਤੀਆਂ ‘ਤੇ ਵਿਚਾਰ ਕਰਨਾ ਹੈ।
ਸਾਰੇ ਕਾਰਜਾਂ ਵਿੱਚ, ਸੰਭਾਵਿਤ ਕਾਰਨਾਂ ਦੀ ਸੂਚੀ (ਇੱਕ ਸ਼ੁਰੂਆਤੀ ਅਤੇ ਨਾਜ਼ੁਕ ਕਦਮ) ਸੀ ਜਿੱਥੇ AI ਨੇ ਸਭ ਤੋਂ ਮਾੜਾ ਪ੍ਰਦਰਸ਼ਨ ਕੀਤਾ।
ਅਧਿਐਨ ਵਿੱਚ ਇਹ ਵੀ ਪਾਇਆ ਗਿਆ ਕਿ ਜਦੋਂ ਵਧੇਰੇ ਡੇਟਾ, ਜਿਵੇਂ ਕਿ ਲੈਬ ਨਤੀਜੇ ਅਤੇ ਸਕੈਨ ਦਿੱਤੇ ਜਾਂਦੇ ਹਨ ਤਾਂ AI ਵਿੱਚ ਸੁਧਾਰ ਹੁੰਦਾ ਹੈ। (ਫੋਟੋ: Getty Images)
ਇਲਾਜ ਬਾਰੇ ਫੈਸਲਾ ਕਰਨ ਜਾਂ ਮਿਸ਼ਰਤ ਕਲੀਨਿਕਲ ਪ੍ਰਸ਼ਨਾਂ ਨੂੰ ਸੰਭਾਲਣ ਵਰਗੇ ਕੰਮ ਸਭ ਤੋਂ ਵਧੀਆ ਨਹੀਂ, ਪਰ ਸਭ ਤੋਂ ਮਾੜੇ ਵੀ ਨਹੀਂ ਹਨ।
ਅਧਿਐਨ ਨੇ ਇਹ ਵੀ ਦੇਖਿਆ ਕਿ ਕੀ AI ਚਿੱਤਰਾਂ ਨੂੰ ਦਿੱਤੇ ਜਾਣ ‘ਤੇ ਬਿਹਤਰ ਪ੍ਰਦਰਸ਼ਨ ਕਰਦਾ ਹੈ, ਜਿਵੇਂ ਕਿ ਐਕਸ-ਰੇ, ਸੀਟੀ ਸਕੈਨ, ਜਾਂ ਹਾਰਟ ਰੀਡਿੰਗ, ਸਿਰਫ਼ ਟੈਕਸਟ ਦੀ ਬਜਾਏ।
GPT-4.5, ਕਲਾਉਡ, ਜੇਮਿਨੀ, ਅਤੇ ਗ੍ਰੋਕ ਸਮੇਤ ਕੁਝ ਮਾਡਲਾਂ ਨੇ ਚਿੱਤਰਾਂ ਨੂੰ ਸ਼ਾਮਲ ਕੀਤੇ ਜਾਣ ‘ਤੇ ਥੋੜ੍ਹਾ ਬਿਹਤਰ ਪ੍ਰਦਰਸ਼ਨ ਕੀਤਾ।
ਪਰ ਇਹ ਸਾਰੇ ਮਾਡਲਾਂ ਲਈ ਸੱਚ ਨਹੀਂ ਸੀ। ਕੁੱਲ ਮਿਲਾ ਕੇ, ਚਿੱਤਰਾਂ ਦੇ ਨਾਲ ਪ੍ਰਦਰਸ਼ਨ ਅਸੰਗਤ ਸੀ, ਜਦੋਂ ਕਿ ਟੈਕਸਟ-ਅਧਾਰਿਤ ਸਵਾਲਾਂ ਨੇ ਵਧੇਰੇ ਸਥਿਰ ਨਤੀਜੇ ਦਿੱਤੇ।
ਡਾਕਟਰ ਅਜੇ ਵੀ ਜ਼ਰੂਰੀ ਹਨ
ਡਾਕਟਰ ਮਾਰਕ ਸੁਕੀ ਨੇ ਕਿਹਾ, “ਏਆਈ ਡਾਕਟਰਾਂ ਨੂੰ ਬਦਲਣ ਲਈ ਤਿਆਰ ਨਹੀਂ ਹੈ। “ਇਹ ਉਹਨਾਂ ਦਾ ਸਮਰਥਨ ਕਰ ਸਕਦਾ ਹੈ, ਪਰ ਸਿਰਫ ਨਜ਼ਦੀਕੀ ਨਿਗਰਾਨੀ ਨਾਲ.”
AI ਸਹਾਇਤਾ ਕਰ ਸਕਦਾ ਹੈ, ਪਰ ਮਨੁੱਖੀ ਨਿਰਣਾ ਜ਼ਰੂਰੀ ਰਹਿੰਦਾ ਹੈ, ਖਾਸ ਤੌਰ ‘ਤੇ ਜਦੋਂ ਨਿਦਾਨ ਦੁਆਰਾ ਸੋਚਣ ਦੀ ਗੱਲ ਆਉਂਦੀ ਹੈ, ਨਾ ਕਿ ਸਿਰਫ ਇਸਦਾ ਨਾਮ ਦੇਣਾ।
ਅਧਿਐਨ ਨੇ ਸਿੱਟਾ ਕੱਢਿਆ ਕਿ ਹਾਲਾਂਕਿ ਨਵੇਂ ਸੰਸਕਰਣਾਂ ਵਿੱਚ ਸੁਧਾਰ ਹੋ ਰਿਹਾ ਹੈ, ਇਹ AI ਟੂਲ ਅਜੇ ਵੀ ਇੰਨੇ ਭਰੋਸੇਮੰਦ ਨਹੀਂ ਹਨ ਕਿ ਸਿਹਤ ਸੰਭਾਲ ਵਿੱਚ ਆਪਣੇ ਆਪ ਸੁਰੱਖਿਅਤ ਢੰਗ ਨਾਲ ਵਰਤੇ ਜਾ ਸਕਣ।
ਜਦੋਂ ਡਾਕਟਰ ਵਾਂਗ ਸੋਚਣ ਦੀ ਗੱਲ ਆਉਂਦੀ ਹੈ ਤਾਂ ਉਹ ਘਟਦੇ ਰਹਿੰਦੇ ਹਨ.
– ਖਤਮ ਹੁੰਦਾ ਹੈ
ਦੁਆਰਾ ਪ੍ਰਕਾਸ਼ਿਤ:
ਡੈਫਨੇ ਕਲੇਰੈਂਸ
ਇਸ ‘ਤੇ ਪ੍ਰਕਾਸ਼ਿਤ:
15 ਅਪ੍ਰੈਲ, 2026 3:11 PM IST
ਟਿਊਨ ਇਨ





No Comments